Delitos en España (II): una comparativa internacional (aún muy provisional)
ESte segundo post sobre incidencia delictiva en España haré una comparación de los datos de delitos en España con los de otros países usando datos de la UNDOC. En términos coloquiales pretendo intentar dar una respuesta a la pregunta: ¿es España un país seguro?
En este post voy a utilizar los datos de la la Oficina de las Naciones Unidas para drogas y crimen (UNDOC) sobre delitos para ver la situación de España en estos temas. Ya conté cómo procese estos datos en el anterior post, concretamente aquí.
Solo recordaré aquí que los datos de la UNDOC contienen observaciones de 212 países/regiones sobre 27 tipos de delitos para el periodo 1990-2023. Evidentemente solo algunos países presentan datos para todos los indicadores y parte del periodo muestral. Lo vamos viendo poco a poco.
2 Recordando los datos que procesé
Entre los datos de la UNDOC que me llamaron la atención y que acabé procesando estaban las categorías:
Me centré en 3 categorías de delitos, descargando y procesando un total de 27 tipos de delitos
Intentional Homicide: los datos están aquí. Son datos con mucho detalle porque tiene posibilidad de filtrar por genero, edad, medio, situación etc… etc… pero me centré en un único indicador sin tener en cuenta los “detalles”: “Victims of intentional homicide”
Violent & Sexual Crime: los datos están aquí. Contienen también mucho detalle, pero me centré en procesar 10 indicadores: Serious assault, Kidnapping, Sexual violence, Sexual violence: Rape, Sexual violence: Sexual assault, Sexual violence: Other acts of sexual violence, Sexual Exploitation, Acts intended to induce fear or emotional distress y Acts intended to induce fear or emotional distress: Cyber-related
Corruption & Economic Crime: los datos están aquí. Contienen 16 indicadores: Corruption, Corruption: Bribery, Corruption: Other acts of corruption, Smuggling of migrants, Burglary, Theft, Theft: of a motorized vehicle, Fraud, Fraud: Cyber-related (Cy), Money laundering, Unlawful access to a computer system, Unlawful interference with a computer system or computer data, Acts that cause environmental pollution or degradation, Acts involving the movement of dumping of waste, Trade or
3 Algunos resultados
Voy a utilizar el dataset delitos_UNDOC_tipologia_delitos_2023 que como dije, contiene datos de 27 tipos de delitos para un conjunto de 212 países. Es demasiado grande para poder mostrarlo todo, así que supongo que haré un shiny y aquí solo mostraré algunos resultados para ver cómo es la situación de España en cuanto a incidencia delictiva.
1. Datos disponibles
Lo primero que me da curiosidad es ver qué países tienen más disponibilidad de datos y en qué tipologías de delitos. Lógicamente, los países más ricos seguramente tengan mayor recursos para dedicar a confeccionar estadísticas, en este caso sobre incidencia delictiva. Veámoslo:
En este chunk cargo los datos que ya arreglé:
Código
#- datos crimen UN: https://dataunodc.un.org/#- descargué los datos en marzo de 2025#- en data.mungings arreglé los datos y añadí geometrías#- AQUI parto de esos datos ya arreglados y en el pkglibrary(tidyverse)library(sf)#crim_rel <- pjpv.pkg.datos.2024::UNDOC_delitos_x_relacion_2013_23crim_geo <- pjpv.pkg.datos.2024::UNDOC_geometriascrim_tipos <- pjpv.pkg.datos.2024::UNDOC_delitos_tipologia_1990_2023#- trabajo con dfdf <- crim_tiposdf_dicc <- pjpv.pkg.ff.2024::pjp_dicc(df)df_uniques <- pjpv.pkg.ff.2024::pjp_valores_unicos(df, nn =250)#- mis etiquetas ---------------------------------------------------------------#- arreglo las etiquetas de los delitos para los plotsmy_etiquetas <-c("Serious assault", "Kidnapping", "Sexual violence", "Rape", "Sexual assault", "Sexual violence: other", "Sexual Exploitation", "Induce to fear", "Induce to fear (cyber)", "Homicide", "Corruption", "Bribery", "Corruption: other", "Smuggling of migrants", "Burglary", "Theft", "Theft: vehicles", "Fraud", "Fraud (cyber)", "Money laundering", "Access computer", "Interference computer", "Interception data", "Environmental", "Dumping of waste", "Trade protected species", "Natural resources")df <- df %>%mutate(tipo_delito.pjp = tipo_delito) %>% pjpv.pkg.ff.2024::pjp_ff_etiquetas(vv = tipo_delito.pjp, my_etiquetas= my_etiquetas) %>%relocate(tipo_delito.pjp, .after = tipo_delito)#- quiero mantener Greenland, entonces esta lineacrim_geo <- crim_geo %>%mutate(quitar_para_crimenes =if_else(NAME_ENGL =="Greenland", "No quitar", quitar_para_crimenes))#- voy a poner los nombres de países tal como los usa echarts (x debajo usa tidycountries)crim_geo <- crim_geo %>%filter(!is.na(CNTR_ID)) %>%filter(iso3_code %in% countrycode::codelist$iso3c) %>%#- algunas islitas etc... dplyr::mutate(pais.iso = countrycode::countrycode(sourcevar = iso3_code, origin ="iso3c", destination ="country.name.en"))crim_geo <- crim_geo %>%rename(pais = NAME_ENGL)
Voy a calcular cuantas observaciones tiene cada país. Recuerda que la muestra es de 1990 a 2023 y que hay 27 tipos de delitos
Código
#- q país tiene más observaciones?? (Eslovaquia)zz <- df %>%select(iso3_code, region, country, year, tipo_delito.pjp, tasa_100mil) %>%group_by(iso3_code, region, country) %>%count() %>%arrange(desc(n))
Con estos datos voy a hacer una coropleta; así que he de añadir las geometrías:
Código
#- fusiono geometrías con datos de crímenes (Nº de observaciones)zz_m <-left_join(crim_geo %>%filter(quitar_para_crimenes !="Si quitar"), zz, by =c("iso3_code"="iso3_code")) %>%mutate(n =as.integer(n))
Como creo que en esta serie de posts voy a hacer unas cuantas coropletas, he implementado unsa serie de funciones, así que las cargo para poder usarlas:
Código
#- cargo funciones para coropletassource(here::here("_funciones", "_mys_ff.R"))
Una vez cargadas las funciones, ya puedo usarlas. Uasré dos funciones, una para hacer coropletas con el paquete leaflet y la segunda para hacer coropletas con el paquete echarts4r. Cada una de ellas tiene ciertas ventajas: con leaflet puedes hacer zoom y con echarts4r al seleccionar un país se activa un tooltip donde se muestra la posición del país seleccionado y algo muy útil, el tooltip se puede utilizar para seleccionar grupos de países en función del valor de la variable asociado al tooltip. Veámoslas en acción. Un poco más abajo las tienes.
Lo que se aprecia en las 2 coropletas es algo en principio esperado, los países más ricos1, los países “occidentales” son los que más datos disponen. El caso contrario es África con muchas menos observaciones disponibles y en algunos países con ninguna observación.Me han sorprendido algunos resultados resultados, pero solo remarcaré dos: 1) Mongolia con solo 20 observaciones menos que España 2) la aparente división de America del Sur en dos bloques, con los países del litoral Pacifico con muchas observaciones, y 3) las pocas observaciones disponibles en países como China,
Coropleta con leaflet
Código
# Para guardar el mapa como un archivo HTML (opcional)# library(htmlwidgets)# saveWidget(mapa, file = "mapa_coropletico.html")p_coro_leaflet_II(zz_m, n, obs_label ="Nº observaciones", view_zoom =3)
Coropleta con echarts
Código
p <-create_echarts_map(zz_m, iso_col ="pais.iso", value_col ="n")p |>e_theme("vintage")
Vamos a ver la misma información, pero de otra forma:
Código
##- 1.b: Boxplot --------#- tb puedo hacer tb un boxplot (por continente) like this:#- quiero reordenar los boxzz <- zz %>%mutate(region = forcats::as_factor(region)) %>%group_by(region) %>%mutate(mean_n =mean(n, na.rm =TRUE)) %>%ungroup() %>%mutate(region = forcats::fct_reorder(region, mean_n)) %>%mutate(region.x = region)#- solo pongo los labels (iso3_code)#- quiero poner el nombre del país (country) en el tooltip pero no lo consigop <-ggplot(zz, aes(y = n, x = region, color = region.x)) +geom_boxplot(outlier.shape =NA) +#geom_jitter(aes(y = n, x = reorder(region, n, median))) +#geom_point(aes(label = country), x = 0, y = 0, color = "black", size = 1) +geom_text(aes(label = iso3_code), position =position_jitter(), color ="black", size =2.3) #- no consigo que en el tooltip se vea "country"pp <- plotly::ggplotly(p, tooltip =c("region", "country", "n"))#- TODO: probar a hacer el plot con el pkg ggigraph: #- un ejemplo de plot: https://github.com/deepdk/TidyTuesday2024/tree/main/2024/week_33pp
Otra versión del mismo boxplot. Falta ordenar mejor los isocodes del segundo plot
Otra version del mismo plot (con la cuarta intentona de la función)
Código
# Renombrar columnas (como lo tenías)zzz <- zz %>%rename(pais = country) %>%rename(iso3 = iso3_code)# Llamar a la función para crear el objeto girafepp <-crear_boxplot_interactivo(zzz)pp
Gráfico 1: Boxplot interactivo de valores por región y lista de códigos ISO3.
2. Delitos con más observaciones
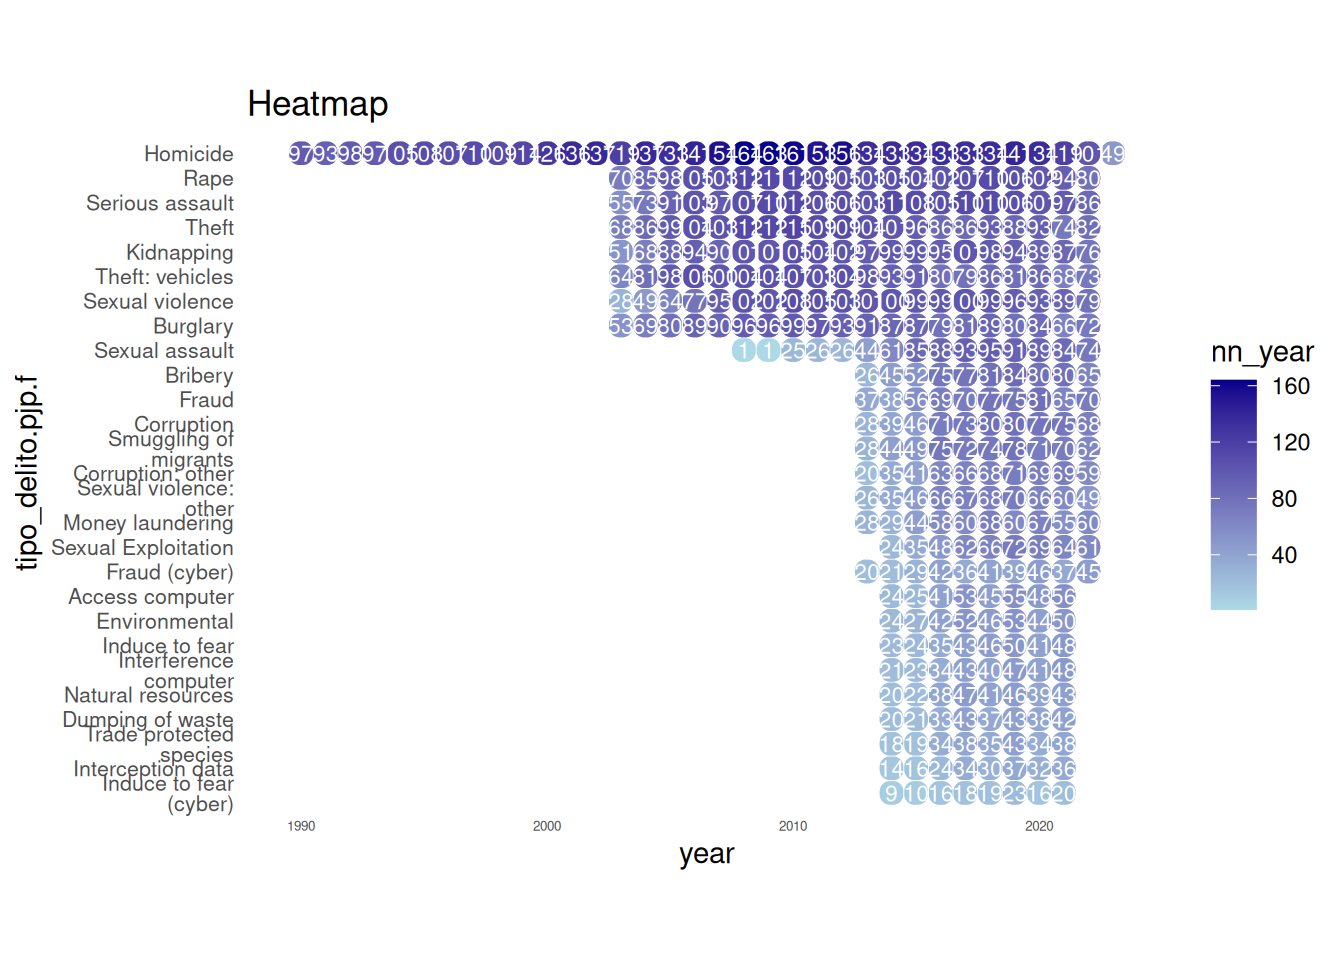
Quiero ver qué delitos, de los 27 tipos que existen en la base de datos, tienen más observaciones.
Código
#- 3. nº de obs x delito y año -------------------------------------------------#- quiero ver q delito tiene más observaciones x año#- para graficar una rounded heatmapzz <- df %>%select(iso3_code, country, year, tipo_delito.pjp, tasa_100mil) %>%group_by(tipo_delito.pjp) %>%mutate(nn_total =n()) %>%ungroup() %>%group_by(tipo_delito.pjp, year) %>%mutate(nn_year =n()) %>%ungroup() %>%select(-iso3_code, -country, -tasa_100mil) %>%distinct(tipo_delito.pjp, year, nn_total, nn_year) %>%arrange(year) zz_t <- zz %>%pivot_wider(names_from = year, values_from = nn_year)
Código
#- paso a factor y reordeno niveles para el plot zzz <- zz %>%mutate(tipo_delito.pjp.f =as.factor(tipo_delito.pjp)) %>%mutate(tipo_delito.pjp.f = forcats::fct_reorder(tipo_delito.pjp.f, nn_total))
Como puedes ver el plot no se acaba de ver bien, he de ajustar los tamaños, pero … ya lo haré más adelante, cuando tenga tiempo. Peto cuando se vea bien, podrás observar que el tipo de delito con más registros es “Homicide” con datos registrados desde 1990 hasta 2023; además con muchos registros de países, generalmente por encima de 100 países y un máximo de 160 países en 2008. Después viene un grupo de delitos (“Rape”, “Serious assault”, “Theft”, “Kidnapping”, “Theft: vehicles”, “Sexual violence” y “Burglary”) con registros de bastantes países (cerca de 100) y para el periodo 2003 a 2022 aproximadamente.
Seguro que se ve mejor en una tabla:
3. Observaciones por países
Código
#- 4. nº de obs x pais y delito ------------------------------------------------zz <- df %>%select(iso3_code, country, year, tipo_delito.pjp, tasa_100mil) %>%group_by(iso3_code, country) %>%mutate(nn_total =n()) %>%ungroup() %>%group_by(iso3_code, country, tipo_delito.pjp) %>%mutate(nn_delito =n()) %>%ungroup() %>%select(-year, -tasa_100mil) %>%distinct() zz_t <- zz %>%pivot_wider(names_from = tipo_delito.pjp, values_from = nn_delito) ##- 2.a#- paso a factor y reordeno niveles para el plotzzz <- zz %>%mutate(country.f =as.factor(country)) %>%mutate(country.f = forcats::fct_reorder(country.f, nn_delito)) %>%mutate(tipo_delito.pjp.f =as.factor(tipo_delito.pjp)) zzzz <- zzz %>%mutate(tipo_delito.pjp.f =as.factor(tipo_delito.pjp)) %>%group_by(tipo_delito.pjp.f) %>%mutate(nn_total_deito =sum(nn_delito)) %>%ungroup() %>%mutate(tipo_delito.pjp.f = forcats::fct_reorder(tipo_delito.pjp.f, nn_total_deito))
Voy a empezar con el delito más grave: “Victims of intentional homicide”. OK, solo un indicador, pero … ¿qué año muestro? hay datos para el periodo 1990-2023, pero en 2023 solo hay 49 países con datos; mientras que para 2022 hay 1012
Näsi, Matti, Maiju Tanskanen, Janne Kivivuori, Paula Haara, y Esa Reunanen. 2021. «Crime NewsConsumption and Fear of Violence: TheRole of TraditionalMedia, SocialMedia, and AlternativeInformationSources». Crime & Delinquency 67 (4): 574-600. https://doi.org/10.1177/0011128720922539.
Notas
Iba a decir más desarrollados, pero dado los tiempos que vivimos no me atrevo a decirlo↩︎
El año que más países tienen datos es 2008 con 165↩︎